
9.3 dsh 识图:给纯文本模型装上眼睛
本节目标
认识 modlens 插件:装好后,DeepSeek、GLM 等纯文本模型也能读图,直接在 dsh 里粘贴图片并提问。
为什么需要识图
DeepSeek 和 GLM 的聊天模型本身是纯文本的,看不了图片。但工作里读图的场景很常见:截图里的表格、UI 设计稿、会议纪要白板、数据可视化、朋友圈海报……
modlens 是社区为 dsh 做的视觉外挂。它不改模型本身,而是在请求时把图片转成结构化文字证据(OCR、版面、语义),再交给纯文本模型回答。换句话说,它给纯文本模型临时装上眼睛。
安装 modlens
和 9.1、9.2 的插件一样,一条命令安装:
dsh plugin --profile web add @liustack/modlens装完重启 dsh web,打开设置 → 插件,就能看到 视觉引擎 (ModLens) 的配置卡片:
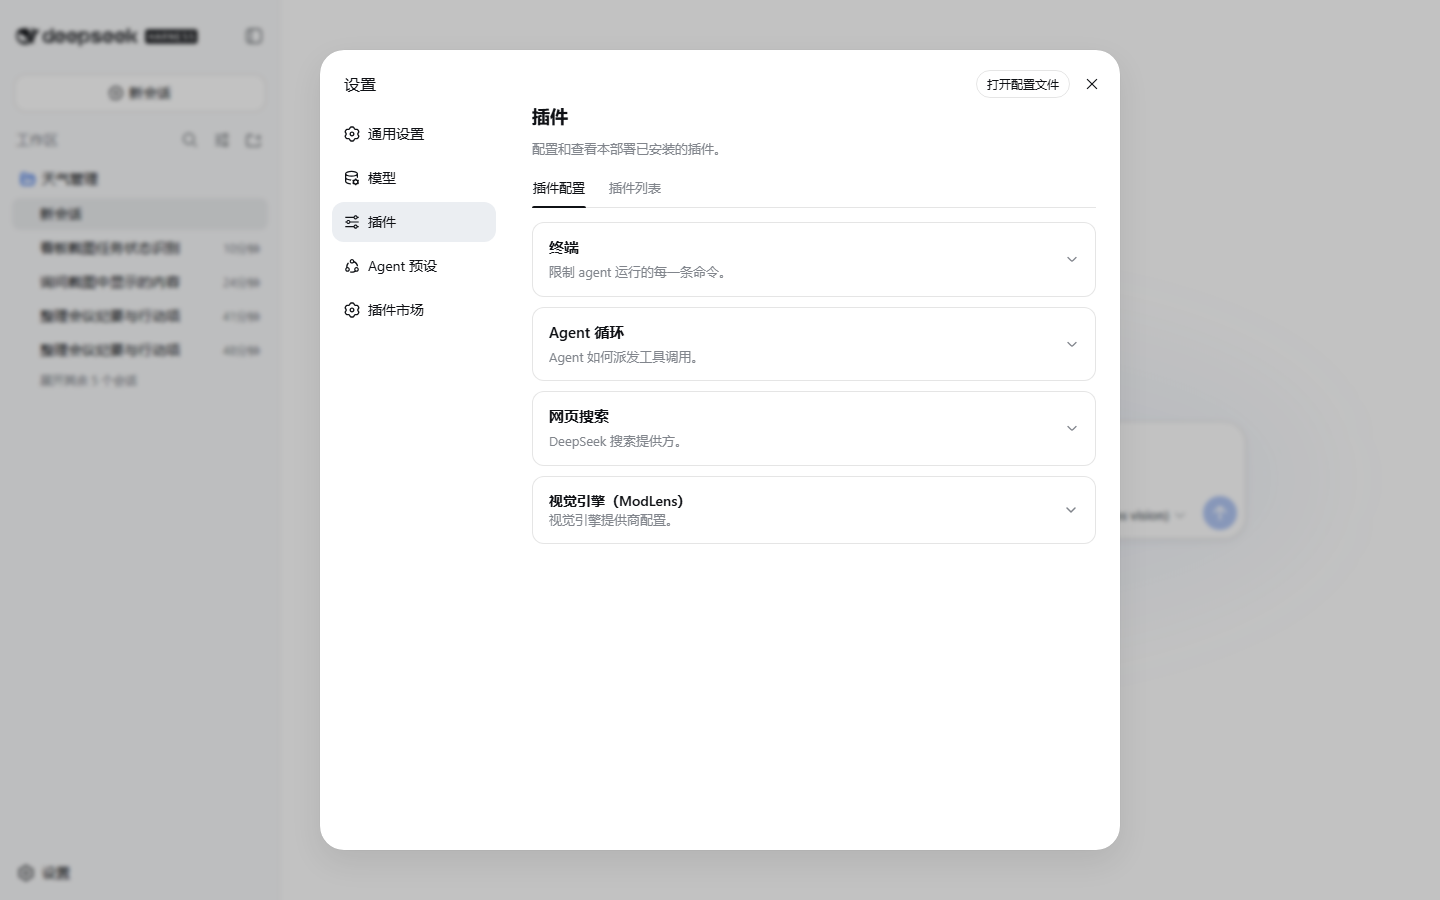
配置视觉引擎
modlens 不依赖单一视觉服务,常见的可用来源包括:
| 引擎 | 条件 | 大致速度 |
|---|---|---|
| Gemini API | 免费 Google AI Studio key | 5-10 秒 |
| OpenAI 兼容端点 | baseURL + apiKey + model | 5-10 秒 |
| Anthropic | Claude API key | 5-10 秒 |
| 复用本机 CLI | 已登录的 Claude Code / Kimi Code | 20-45 秒 |
| Antigravity CLI | 免费 agy 账号 | 15-45 秒 |
不确定本机状态时,在终端运行:
modlens doctor它会列出哪些引擎可用、缺什么配置,以及复用了哪些本机登录。
实战:读一张项目看板截图
下面这张演示图是一张Q3 项目进度看板,包含三列状态(待处理 / 进行中 / 已完成)和 7 条任务:
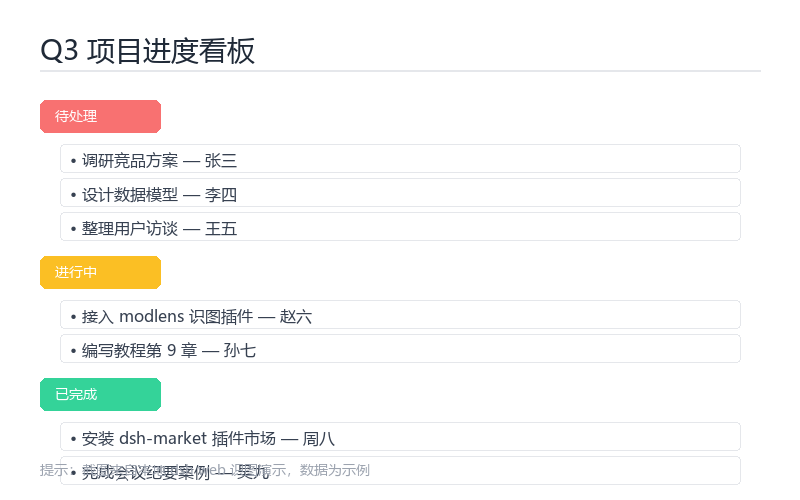
在 dsh web 里这样问:
第一步:切换到带 modlens 的模型
点开模型选择器,选择 glm-5.3-flash (modlens vision)。modlens 会自动为符合条件的纯文本模型生成这种带 (modlens vision) 后缀的包裹项:
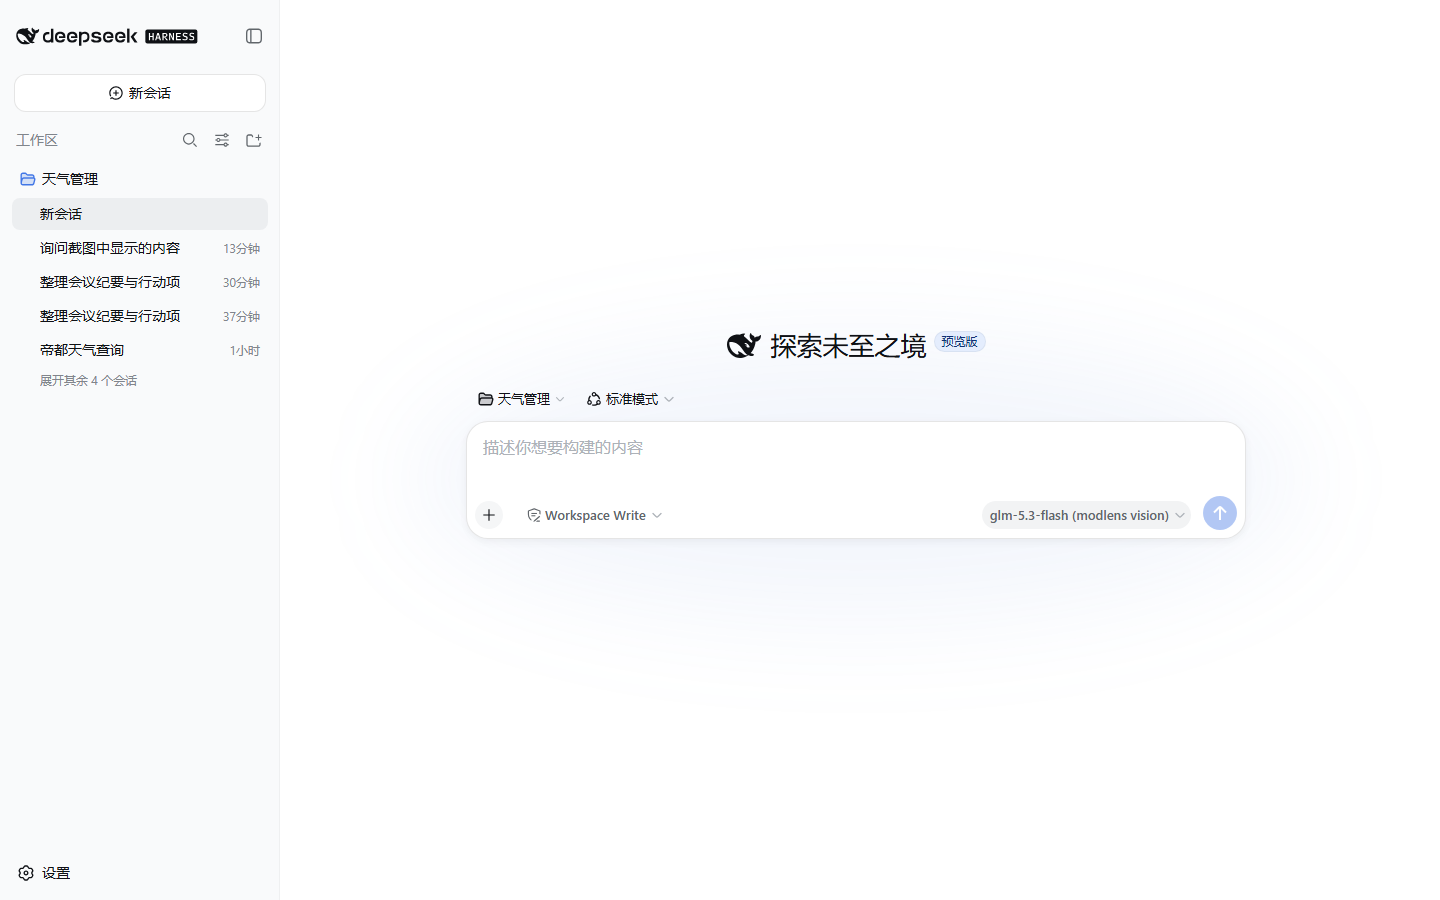
第二步:粘贴图片
直接把截图粘贴到输入框里。选了 (modlens vision) 后,图片会以缩略图形式留在消息中:
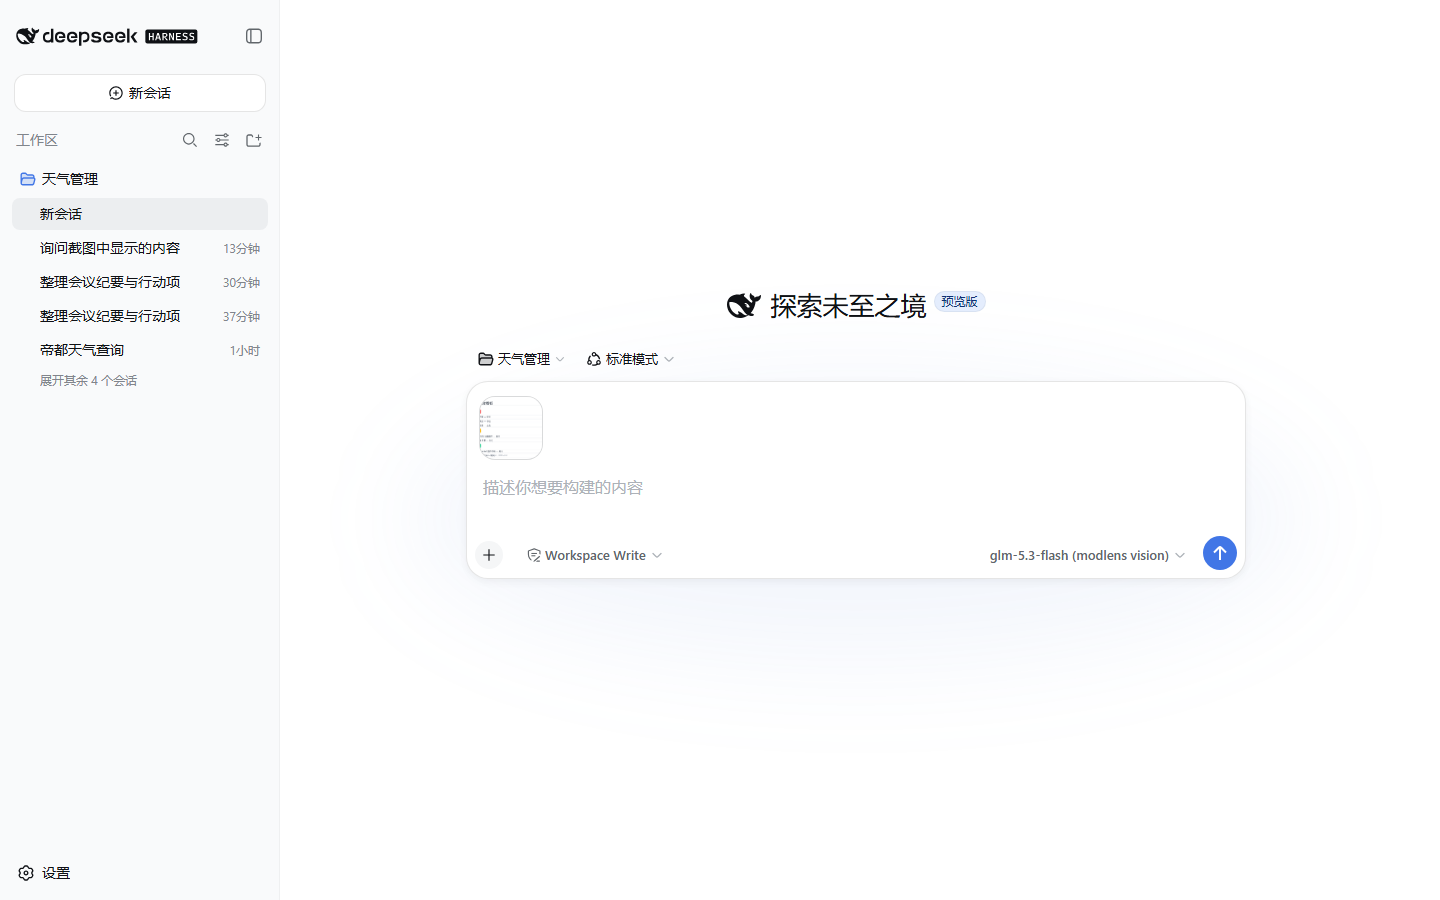
第三步:输入问题并发送
例如:
这张看板截图里有哪些任务,分别是什么状态?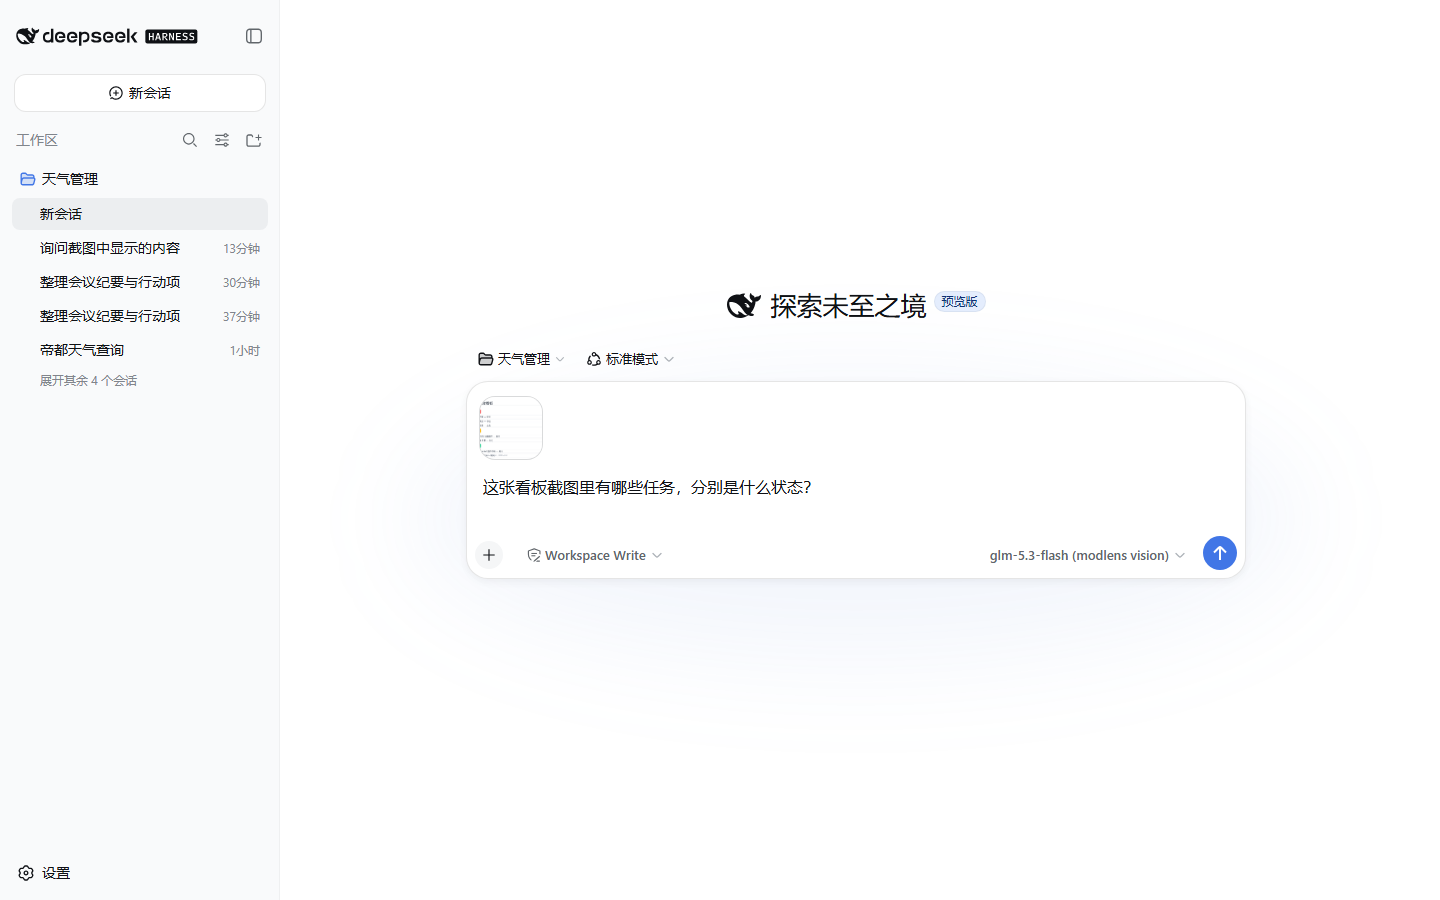
按回车发送。
第四步:看模型怎么回答
模型会把图片里的 7 条任务按状态分组,整理成清晰的表格,并指出负责人:
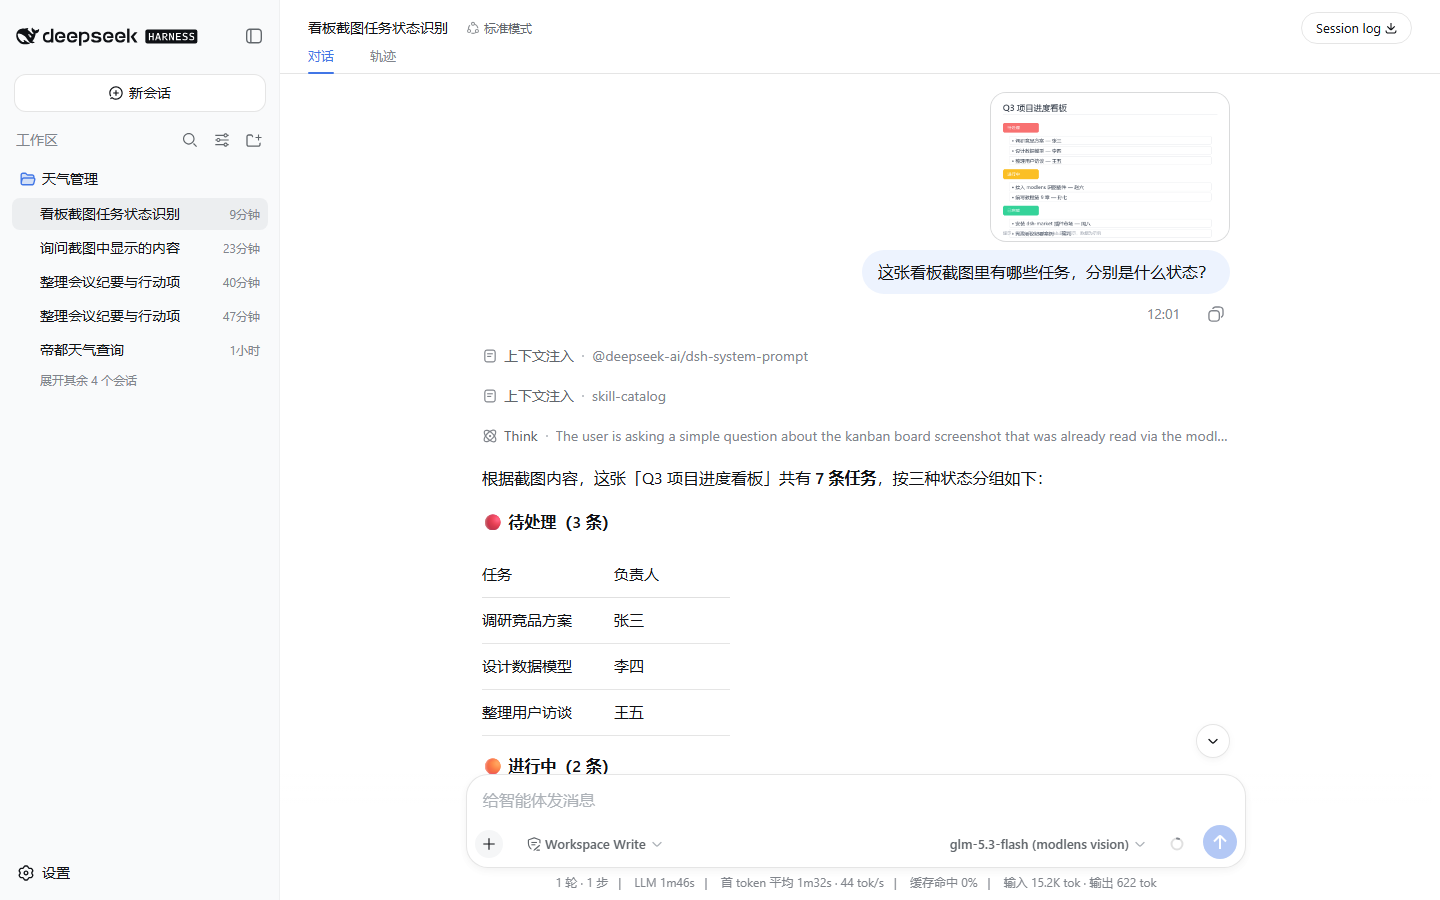
继续往下滚动,能看到完整的分组结果:
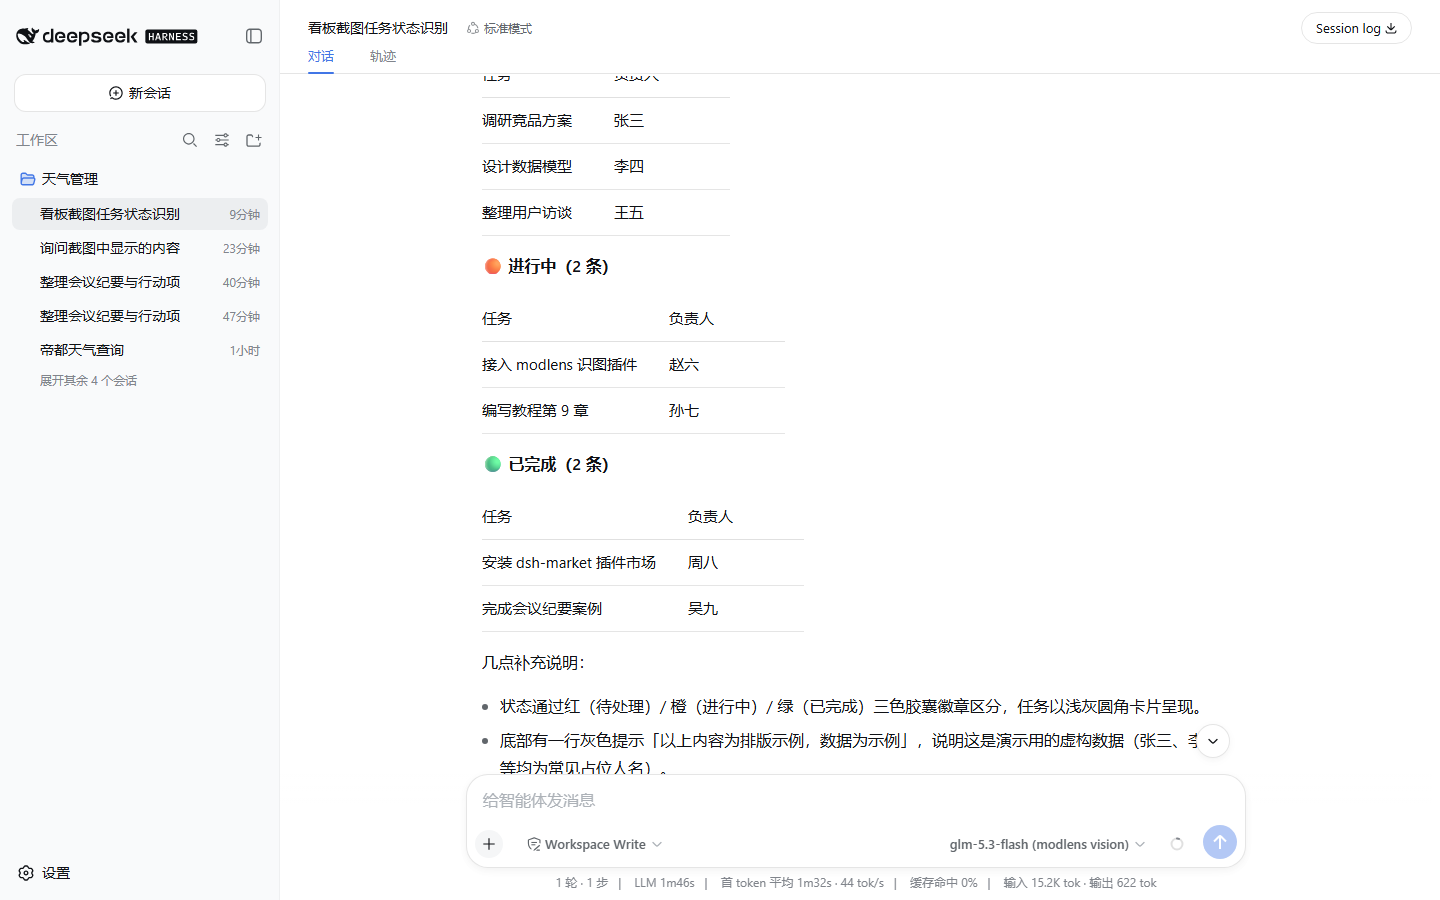
从结果可以看出,模型不仅读出了文字,还理解了颜色标签对应的语义:红色 = 待处理、橙黄 = 进行中、绿色 = 已完成。
第五步:在轨迹里回看流程
切到轨迹页,能看到这次请求的关键节点:用户提问、系统上下文、模型根据已读取的视觉证据组织回答。
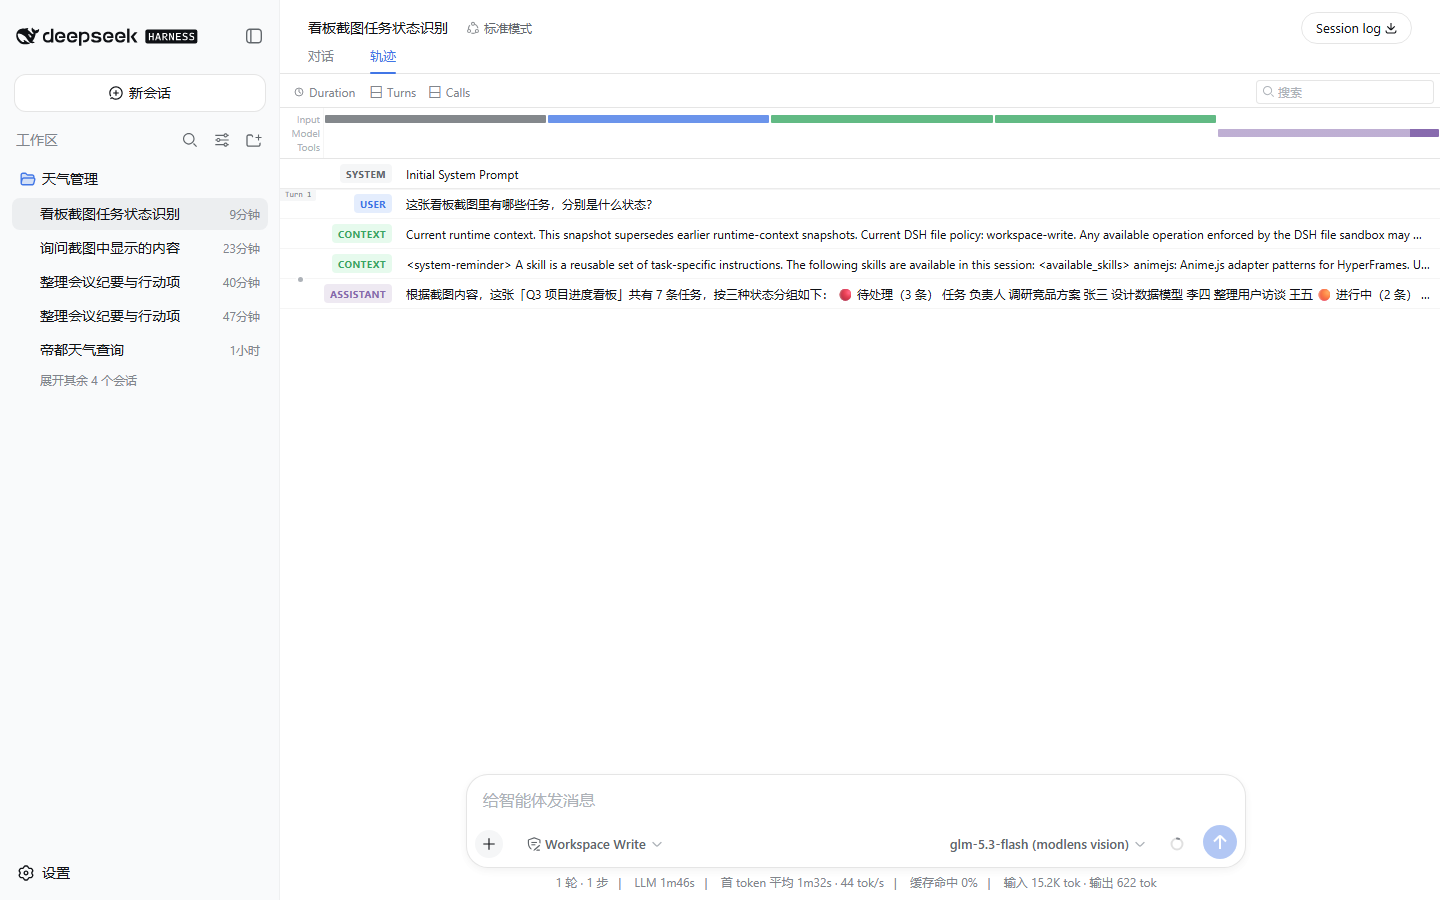
注:使用
(modlens vision)包裹项时,图片转换在请求时由 modlens 完成,所以对话页不会额外显示一个 modlens_read_image 工具行;如果直接粘贴到普通纯文本模型上,则会以工具调用的形式出现。
两种粘贴模式怎么选
modlens 支持两种交互方式:
| 方式 | 操作 | 体验 | 适合场景 |
|---|---|---|---|
| 直接粘贴 | 在普通纯文本模型上粘贴图片 | 图片变成临时文件路径,触发 modlens_read_image 工具 | 临时读一张图,不常用 |
| 选 (modlens vision) 模型 | 先选包裹项,再粘贴 | 缩略图保留在消息里,更像原生视觉模型 | 常用推荐 |
日常推荐第二种,视觉体验更接近 Codex / ChatGPT 的原生图片对话。
常见问题
问:为什么我粘贴图片后模型说看不见?
检查两点:
- 是否选了带 (modlens vision) 后缀的模型;
- 视觉引擎是否配置好(运行
modlens doctor确认)。
问:modlens 和原生视觉模型有什么区别?
modlens 是外挂:图片先由外部视觉引擎转成文字证据,再交给纯文本模型。原生视觉模型是模型自己读图。modlens 的好处是让 DeepSeek、GLM 等纯文本模型立刻获得识图能力,缺点是依赖外部引擎的可用性和速度。
问:支持哪些图片格式?
.png、.jpg、.jpeg、.webp、.gif、.heic、.heif。
问:图片里如果有敏感信息怎么办?
图片会发送到 modlens 配置的视觉引擎提供商(Gemini、Claude、OpenAI 等)。涉及敏感截图时,请选择本地复用引擎或私有化端点,并仔细阅读对应服务商的隐私政策。
小结
- modlens 让 DeepSeek、GLM 等纯文本模型获得识图能力
- 安装命令:
dsh plugin --profile web add @liustack/modlens - 使用方式:选
(modlens vision)模型 → 粘贴图片 → 提问 - 视觉引擎可配 Gemini / OpenAI 兼容端点 / Anthropic / 本机 CLI 复用
装上 modlens 后,dsh 就从只能读文字进化到文字 + 图片都能读。下一章开始,我们把这些能力放进真实工作场景里练手。